文本挖掘
概述
(此页面暂无内容)
噪声词过滤
节点用途: 噪声词过滤节点的功能是将分词字段中的无关词汇或者不重要的词过滤掉,进而筛选出重要的词汇,可过滤中文或者英文。
过滤的方法有多种,分别是过滤与内置的噪声词库匹配的词汇、过滤与自定义噪声词库匹配的词汇、过滤所有的标点符号、过滤所有的数字、区分大小写和过滤所有字节长度小于N的词。这些方法可以只选择一个进行过滤,也可以选择全部进行过滤。过滤后输出表中的列数保持不变,只会过滤掉匹配条件的记录。
节点配置:
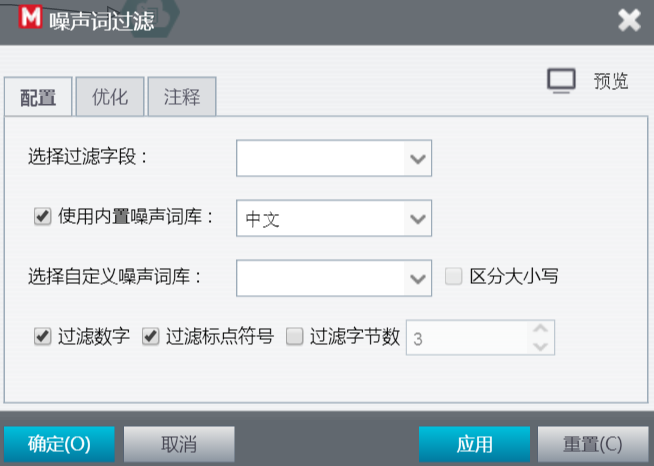
配置选项卡
 说明:
- 选择过滤字段:选择文档中所需过滤字段
- **使用内置噪声词库:**如果勾选此项,将会过滤掉分词字段中与内置噪声词库匹配的记录,可选择中英文
- **选择自定义噪声词库:**如果您需要让程序根据您指定的噪声词汇进行过滤,请将包含您指定的包含噪声词的表连接到第二个输入端口(自定义噪声词库)。如果选择使用自定义噪声词库,请在后面下拉框中选择包含噪声词的字段。
- **过滤数字:**如果勾选此项,将会过滤掉选择的分词字段中所有只有数字组成的词
- **过滤标点符号:**如果勾选此项,将会过滤掉选择的分词字段中所有只有标点符号组成的词
- **区分大小写:**如果勾选此项,在与噪声词库中的词匹配时会区分大小写
- **过滤字节数:**如果勾选此项,还需要在后面的文本框中定义字节数,将会过滤掉选择的分词字段中所有字节长度小于指定值的词。
字符串匹配
**节点用途:**字符串匹配节点的功能是对两个字符串字段进行比较,计算两个字段中字符串之间的距离,并在输出表中列出最相似的字符串。
该节点需要两个输入表,一个表包含用于比较的字符串字段,一个表包含一个词典字段。字符串匹配节点会寻找词典字段中与指定的字符串字段中最相似的元素。
节点配置:
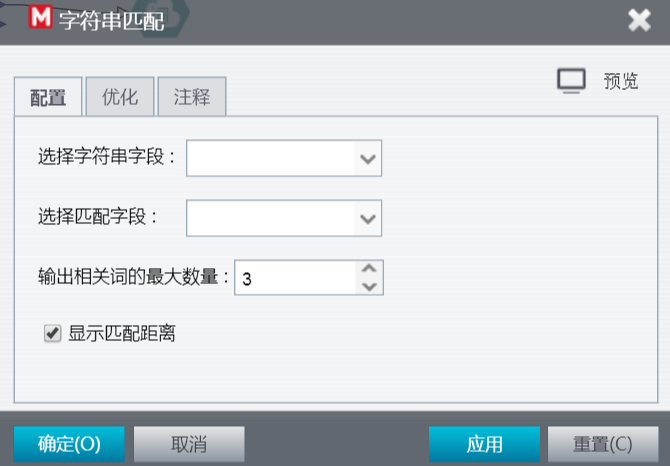
配置选项卡
 说明:
- **选择字符串字段:**选择数据表中所需要的字符串字段。该列来自于第一个输入表
- **选择匹配字段:**选择一个与字符串列对比的词匹配字段。该匹配字段来自于第二个输入表(词典表)。程序将会从这个词典列中找出与目标字段中相关的元素
- **输出相关词的最大数量:**指定相关词的最大数量,即要从字典表中最多找到几个与字符串列中的元素相关的元素。如果指定的值为3,输出表中将会增加三个相关字段,分别命名为“相关词1”、“相关词2”和“相关词3”,计算得到的与字符串每个元素相关的元素会分别保存在这三个字段中
- **显示匹配距离:**在输出表中显示目标字段与匹配字段间差异
语句提取
**节点用途:**语句提取节点的功能是提取文档中的语句并返回一个包含文档字段、语句字段和表示语句中包含的词量字段的表。
节点配置:
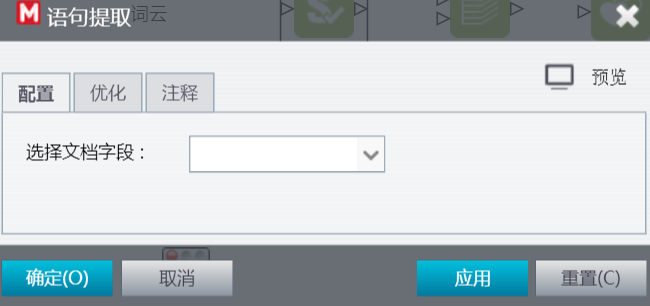
配置选项卡
- **选择文档字段:**选择数据表中所需要的字符串字段
分词
节点用途: 分词节点的功能是用于对中文,英文文本进行分词,进而从非结构化数据中提取结构信息。
分词的对象都是每列字段。分词后将在输出表中追加分词、计数和词性三个字段。分词字段表示从文本字段中提取出词;计数字段表示按照每个文本对得到每个分词出现次数的统计,注意,统计的只是每次词所在文本中出现的次数,并不是所有文本中出现的次数;词性字段显示的每个分词的词性。
节点配置:
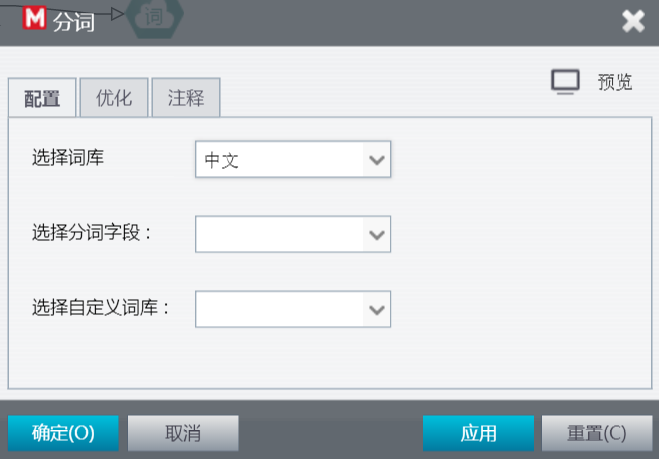
配置选项卡
 说明:
- **选择词库:**选择适合分词的词库,中文或者是英文
- **选择分词的字段:**请在这里选择要分词的文本字段。分词程序将对该字段进行分词
- **选择自定义词库:**从自定义词库输入表中选择包含新增词的字段。这个功能主要用于自定义词库,用户可以基于该功能将一些词库中没有的新词添加到分词词库中,以提高分词的准确率。这些新增词在程序执行后不会添加到程序自带的词库中,只是临时使用。
情感分析
**节点用途:**这个节点根据情感分析节点的功能是定义文本的情感强度和情感分类。文本情感分析又称意见挖掘。简单而言,是对带有情感色彩的主观性文本进行分析、处理、归纳和推理的过程。例如,由于基于产品评论的情感分析可以帮助用户了解某一产品在大众心目中的口碑,因此受到很多消费者和商业网站的青睐。而基于新闻评论的情感分析多用于舆情监控和信息预测中,是国内外评测中重要的评测任务。
情感信息抽取是情感分析的最底层的任务,它旨在抽取情感评论文本中有意义的信息单元。其目的在于将无结构化的情感文本转化为计算机容易识别和处理的结构化文本,继而供情感分析上层的研究和应用服务。情感信息分类则利用底层情感信息抽取的结果将情感文本单元分为若干类别,供用户查看,如分为褒、贬两类或者其他更细致的情感类别(如喜、怒、哀、乐等)。按照不同的分类目的,可分为主客观分析和褒贬分析;按照不同的分类粒度,可分为词语级、短语级、篇章级等多种情感分类任务。
节点配置:
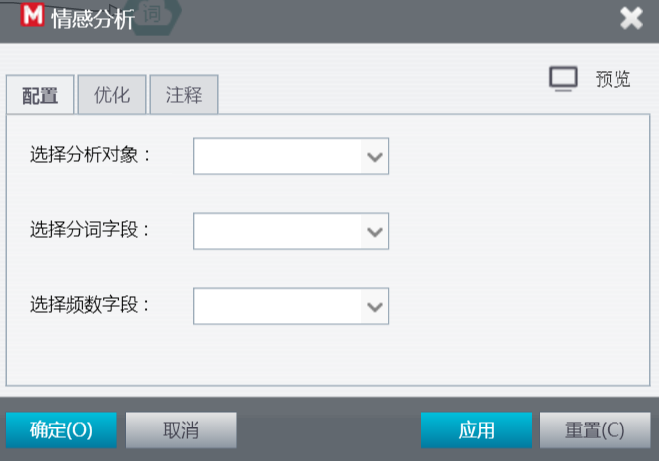
配置选项卡
 说明:
- **选择分析对象 :**情感分析是面向研究对象的,可以是每条记录,也可以是文档类别,也可以是文本的作者。因此,需要选择分析的对象,情感分析会按照选择的分析对象计算每个对象的情感强度,进而计算情感分类。这一项不是必选项,如果不选,则程序会把每条记录当作一个分析对象
- 选择分词字段: 由于情感分析需要根据文本中词判断词的情感,进而计算每个研究对象的所有文本整体的情感强度,即为该研究对象的情感强度。因此,在做情感分析之前需要使用分词节点对文本进行分词(有时还需要对分词进行噪声词过滤)。因此,此处需要选择一个之前已经处理好的分词字段
- **选择频数字段:**这一项是指定情感分析的权重,可以选择一个数值型字段作为权重。此项也非必选,如果不选,则权重默认相同。